

Introduction
Tout marché financier repose sur une hypothèse silencieuse : chaque fois que quelqu’un veut acheter ou vendre, une contrepartie est prête. Cette contrepartie, c’est le teneur de marché : un intervenant qui affiche en même temps un prix d’achat et un prix de vente, achète un peu moins cher et vend un peu plus cher, et gagne en répétant ce petit écart sur un très grand nombre de transactions. Il n’a pas besoin de savoir dans quel sens ira le prix. Son risque est d’avoir traité du mauvais côté juste avant un mouvement important.
Nous avons confié ce travail à un algorithme qui l’a appris du marché lui-même.
Le projet CME Market Maker a rassemblé plusieurs années de données du CME, l’un des plus grands marchés à terme du monde, au niveau de chaque ordre individuel. À partir de ces données, avec l’apprentissage profond et l’analyse statistique, nous sommes parvenus à un algorithme de tenue de marché qui est testé au sein d’une reconstitution fidèle de la bourse elle-même. L’objectif est un desk de tenue de marché automatisé qui gère le capital avec cet algorithme, et non selon le jugement humain du moment.
Rapports du simulateur
Ce projet comprend deux rapports complets du simulateur d’exécution, un par marché. Chaque rapport présente 25 scénarios croisant cinq niveaux de latence de transmission des ordres, de zéro à une milliseconde, avec cinq niveaux de frais. Les deux rapports sont téléchargeables et peuvent être examinés indépendamment de notre analyse.
-
GC Contrats à terme sur l’or
- Déc. 2019 à juil. 2026période de test
- 1 608jours de bourse
- 1 905 921transactions simulées dans le scénario de base
- 25 scénarios5 niveaux de latence × 5 niveaux de frais
Un fichier HTML autonome, 7,6 Mo, en cinq langues
-
NQ Contrats à terme sur le Nasdaq-100
- Mai 2017 à juin 2026période de test
- 2 310jours de bourse
- 2 792 780transactions simulées dans le scénario de base
- 25 scénarios5 niveaux de latence × 5 niveaux de frais
Un fichier HTML autonome, 8,2 Mo, en cinq langues
Il s’agit de résultats de simulation sur des données de marché enregistrées (un backtest), et non de trading réel ; ils ne constituent aucune garantie pour l’avenir. Chaque rapport montre aussi les scénarios perdants.
À l’intérieur de la plateforme
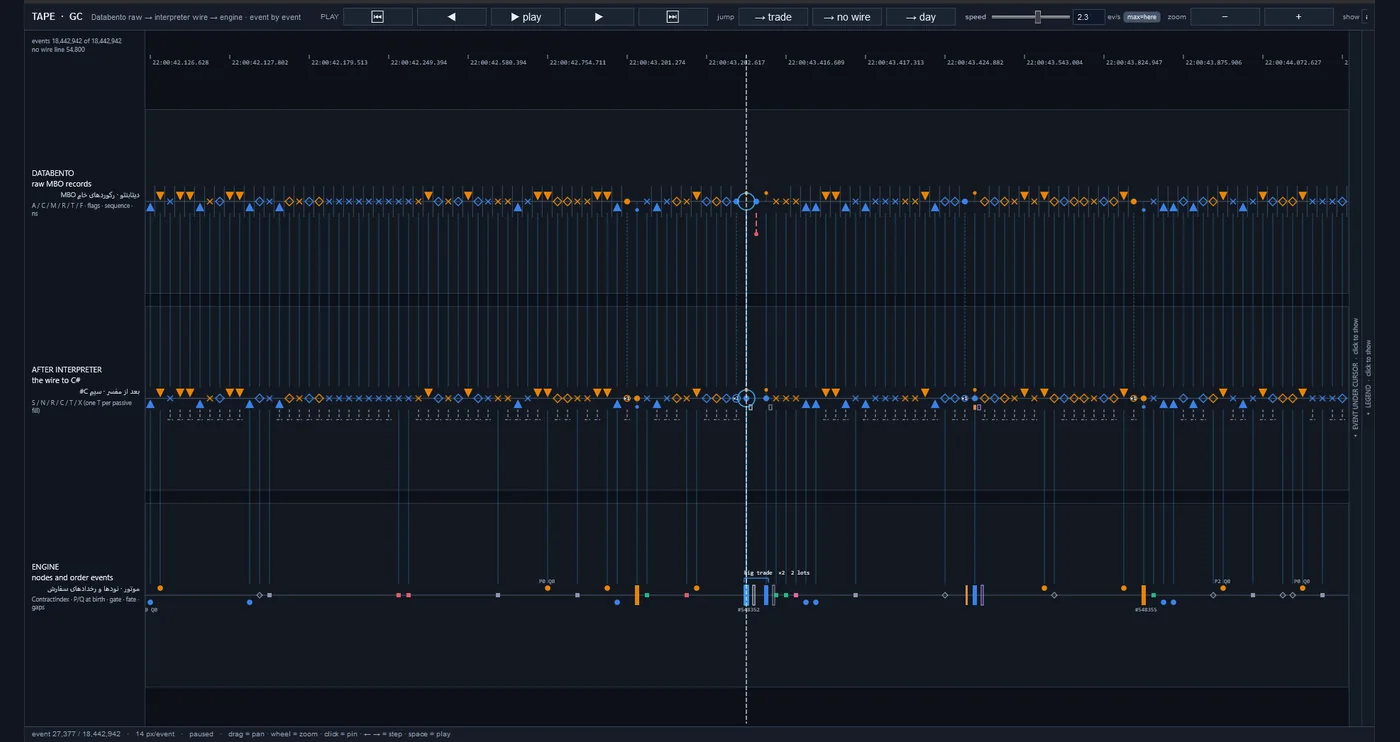
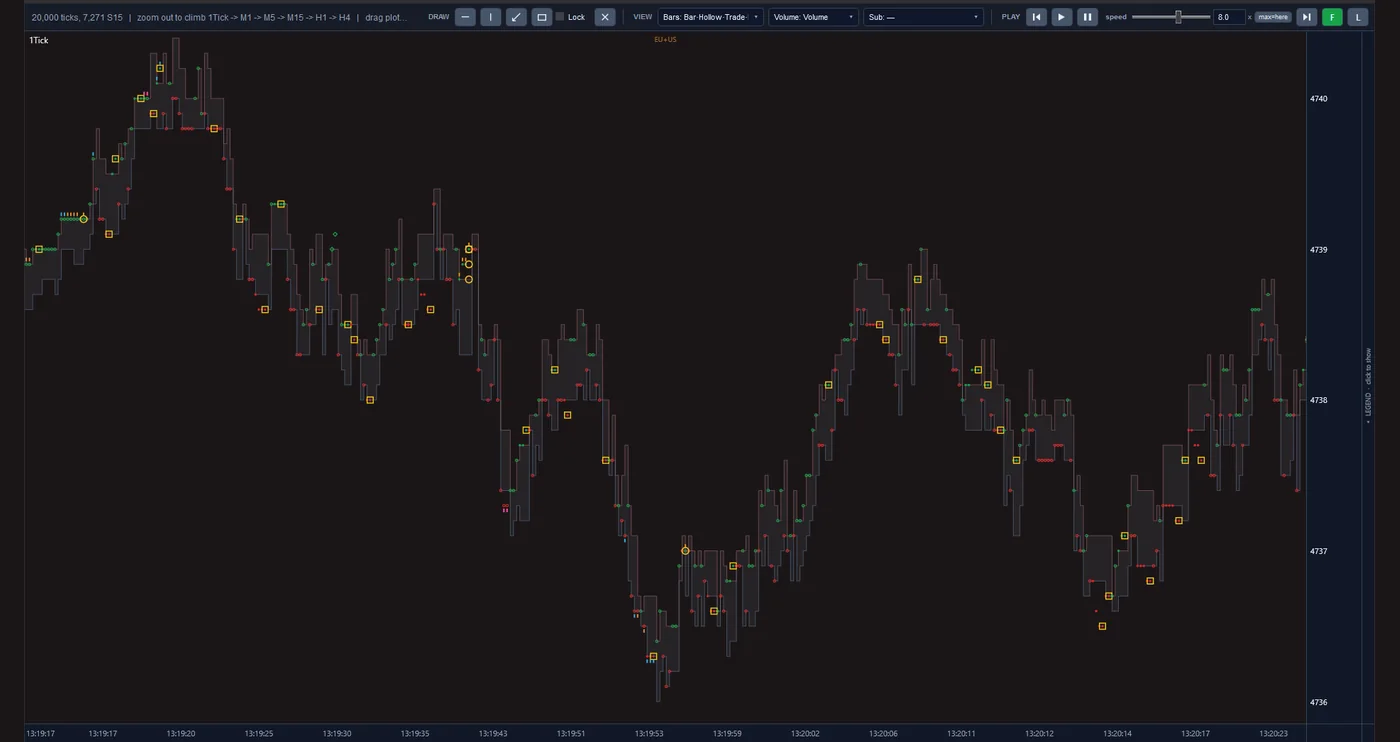
Ce sont de vraies captures d’écran des outils du projet, et non des maquettes. Chaque vue montre les mêmes données de marché ordre par ordre sous un angle différent. Cliquez sur l’image pour l’agrandir.
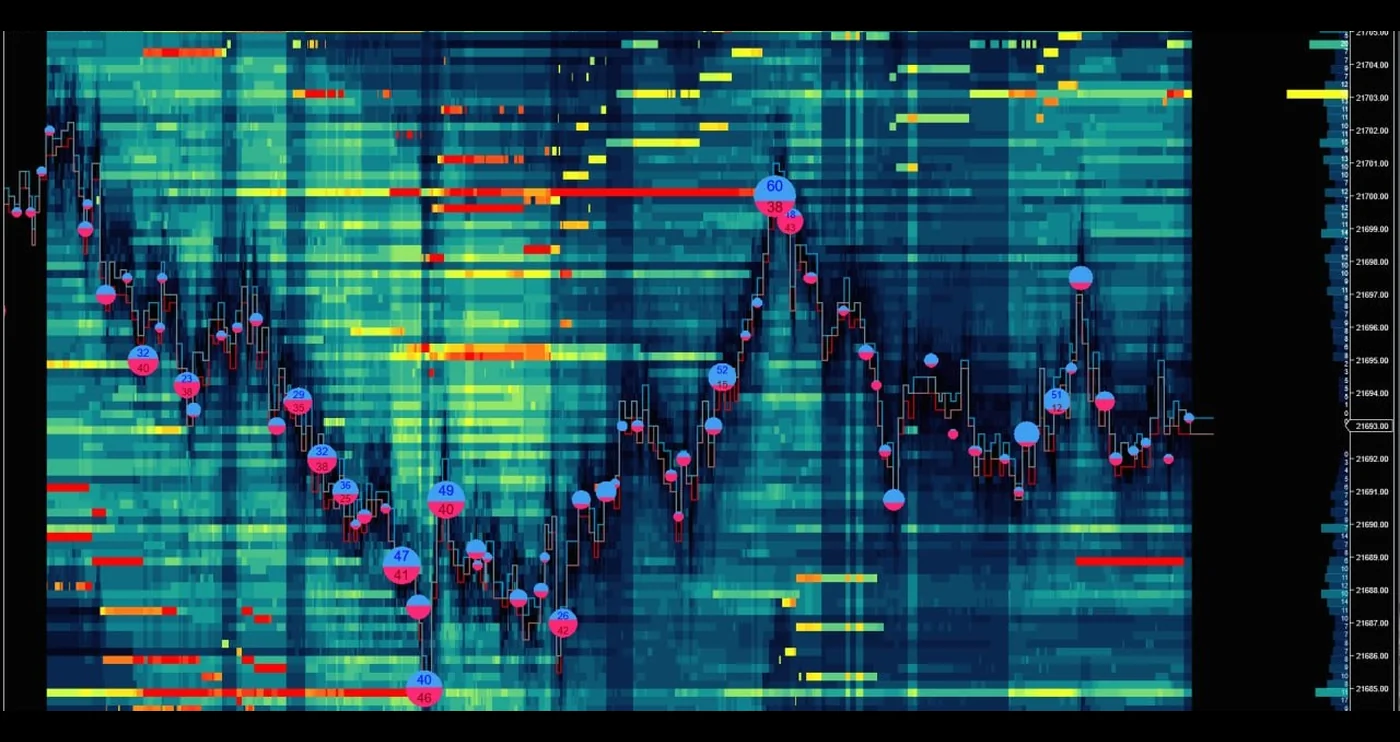
Le volume des ordres en attente à chaque prix et à chaque instant sous forme de carte thermique, la trajectoire du prix par-dessus, et des bulles qui marquent les transactions.
18 442 942 événements, parcourables un par un, sur trois pistes : les enregistrements MBO bruts, les mêmes enregistrements après l’interpréteur, et les nœuds et événements d’ordres dans le moteur.
Un graphique de prix à un tick avec des marqueurs d’événements sur chaque tick. En dézoomant, on passe des ticks à une minute, puis jusqu’à quatre heures.
Approche
L’algorithme apprend à partir des données de marché et est mesuré au sein d’une reconstitution de ce même marché. Le travail a été mené en trois étapes :
-
Des données brutes à l’image complète du marché
L’écran de trading ne présente qu’une synthèse du marché. Nous traitons chaque message enregistré par la bourse pour reconstituer, à chaque instant, la liste des ordres en attente. Nous obtenons ainsi le volume disponible à chaque niveau de prix et la priorité de chaque ordre dans la file d’attente.
-
De l’image du marché à l’algorithme
En apprentissage profond, l’ordinateur apprend des schémas à partir d’exemples réels au lieu de suivre des règles écrites à la main. Avec l’appui de l’analyse statistique, notre algorithme apprend à distinguer les situations favorables et défavorables à une transaction de teneur de marché. Il détermine où placer un ordre, quelles transactions éviter et quand suspendre la cotation.
-
De l’algorithme à l’exécution testée
Une bonne décision doit aussi être exécutable sur le marché réel. Dans notre simulateur, les ordres de l’algorithme atteignent la bourse avec un délai, prennent leur tour dans la file d’attente et influent sur le marché, exactement comme ils le feraient dans la réalité. Le critère d’évaluation est le résultat financier net après tous les coûts.
Points clés
-
Un savoir qui réside dans le système, et et non dans la tête des gens.
La tenue de marché traditionnelle repose sur l’intuition de traders expérimentés, et ce savoir se perd avec leur départ. Notre algorithme a appris ce qu’il sait des données de marché elles-mêmes. Les connaissances acquises sont conservées dans le système, les résultats sont reproductibles et le modèle peut être réentraîné.
-
Une cotation sélective plutôt qu’une présence permanente.
Nous avons évalué une cotation bilatérale systématique en intégrant les coûts réels : elle s’est révélée déficitaire. Sans sélection, le teneur de marché s’expose à la sélection adverse, en étant exécuté juste avant une évolution défavorable du prix. L’algorithme vise précisément à distinguer les transactions à rechercher de celles à éviter.
-
Un résultat qui tient aussi à l’exécution.
De nombreuses stratégies sont rentables sur le papier mais pas en pratique, parce que leur test suppose qu’un ordre est exécuté immédiatement au prix affiché. Dans notre simulateur, un ordre suit le même chemin que sur le marché réel, et l’exactitude de la simulation a été vérifiée par rapport à une reconstitution indépendante réalisée à partir des données brutes de la bourse.
-
Distinguer les résultats robustes des effets du hasard.
Les modèles d’apprentissage peuvent mémoriser le passé sans avoir rien appris sur l’avenir. Pour l’éviter, l’algorithme est toujours mesuré sur des périodes qu’il n’a pas vues pendant l’entraînement, périodes agitées comprises. Chaque constat est aussi confronté à des données délibérément privées de tout schéma significatif, et s’il y apparaît aussi, il est écarté.
-
Évaluer les besoins d’infrastructure avant d’investir.
Dans ce domaine, la vitesse à laquelle un ordre atteint la bourse et les frais de chaque transaction déterminent la frontière entre profit et perte, et améliorer l’un ou l’autre coûte cher. Nous testons l’algorithme sur toute une gamme de ces conditions à la fois. Ainsi, avant tout engagement financier, on sait clairement dans quelles conditions le plan est justifié.
-
Des rapports standard et lisibles.
Le résultat de chaque test est présenté sur une page, avec les mesures et les appellations usuelles du secteur, en cinq langues. Un investisseur ou son conseiller peut lire et évaluer le résultat indépendamment de nous.
Feuille de route
-
Réalisé
L’infrastructure de données, la reconstitution du marché, l’algorithme de tenue de marché, le simulateur d’exécution et le système de rapports sont construits.
-
En cours
Aujourd’hui, nous mesurons l’algorithme dans un test pluriannuel, sous diverses conditions de vitesse et de frais et sur plus d’un marché.
-
Ensuite
Viendront ensuite la connexion aux données en direct, le déploiement à proximité de la bourse et une période d’essai avec un capital limité.
-
Dernière étape
La dernière étape est la tenue de marché avec du capital réel, sous la forme d’un desk automatisé.
Technologie
Les modèles d’apprentissage sont construits en Python et entraînés sur un processeur graphique. Le moteur de reconstitution du marché et le simulateur d’exécution sont écrits en C#, et le lecteur de données brutes en Rust. Une modification n’est acceptée qu’après avoir été comparée à la version précédente et avoir réussi les tests automatisés.