

Einführung
Jeder Finanzmarkt beruht auf einer stillen Annahme: Wann immer jemand kaufen oder verkaufen will, steht eine Gegenpartei bereit. Diese Gegenpartei ist der Market Maker: ein Marktteilnehmer, der gleichzeitig einen Kaufpreis und einen Verkaufspreis stellt, etwas billiger kauft und etwas teurer verkauft und daran verdient, diese kleine Spanne über sehr viele Trades hinweg zu wiederholen. Er muss nicht wissen, in welche Richtung sich der Preis bewegen wird. Sein Risiko ist, kurz vor einer großen Bewegung auf der falschen Seite gehandelt zu haben.
Wir haben diese Aufgabe einem Algorithmus übergeben, der sie vom Markt selbst gelernt hat.
Das Projekt CME Market Maker hat mehrere Jahre der Chicagoer Börse, eines der größten Futures-Märkte der Welt, auf der Ebene jeder einzelnen Order zusammengetragen. Aus diesen Daten sind wir mit Deep Learning und statistischer Analyse zu einem Market-Making-Algorithmus gelangt, der in einer getreuen Nachbildung der Börse selbst getestet wird. Das Ziel ist ein automatisierter Market-Making-Desk, der Kapital mit diesem Algorithmus steuert, nicht mit dem Augenblicksurteil von Menschen.
Simulatorberichte
Dieses Projekt hat zwei vollständige Berichte aus dem Ausführungssimulator, einen je Markt. Jeder Bericht zeigt den Algorithmus in 25 Szenarien zugleich: fünf Stufen der Orderlatenz zur Börse, von null bis eine Millisekunde, bei fünf Gebührenstufen. Sie können beide herunterladen und unabhängig von uns lesen und bewerten.
-
GC Gold-Futures
- Dez. 2019 bis Juli 2026Testzeitraum
- 1.608Handelstage
- 1.905.921simulierte Trades im Basisszenario
- 25 Szenarien5 Latenzstufen × 5 Gebührenstufen
Eine eigenständige HTML-Datei, 7,6 MB, in fünf Sprachen
-
NQ Nasdaq-100-Futures
- Mai 2017 bis Juni 2026Testzeitraum
- 2.310Handelstage
- 2.792.780simulierte Trades im Basisszenario
- 25 Szenarien5 Latenzstufen × 5 Gebührenstufen
Eine eigenständige HTML-Datei, 8,2 MB, in fünf Sprachen
Dies sind Simulationsergebnisse auf aufgezeichneten Marktdaten (ein Backtest), kein echter Handel und keine Garantie für die Zukunft. Jeder Bericht zeigt auch die verlustbringenden Szenarien.
Einblick in die Plattform
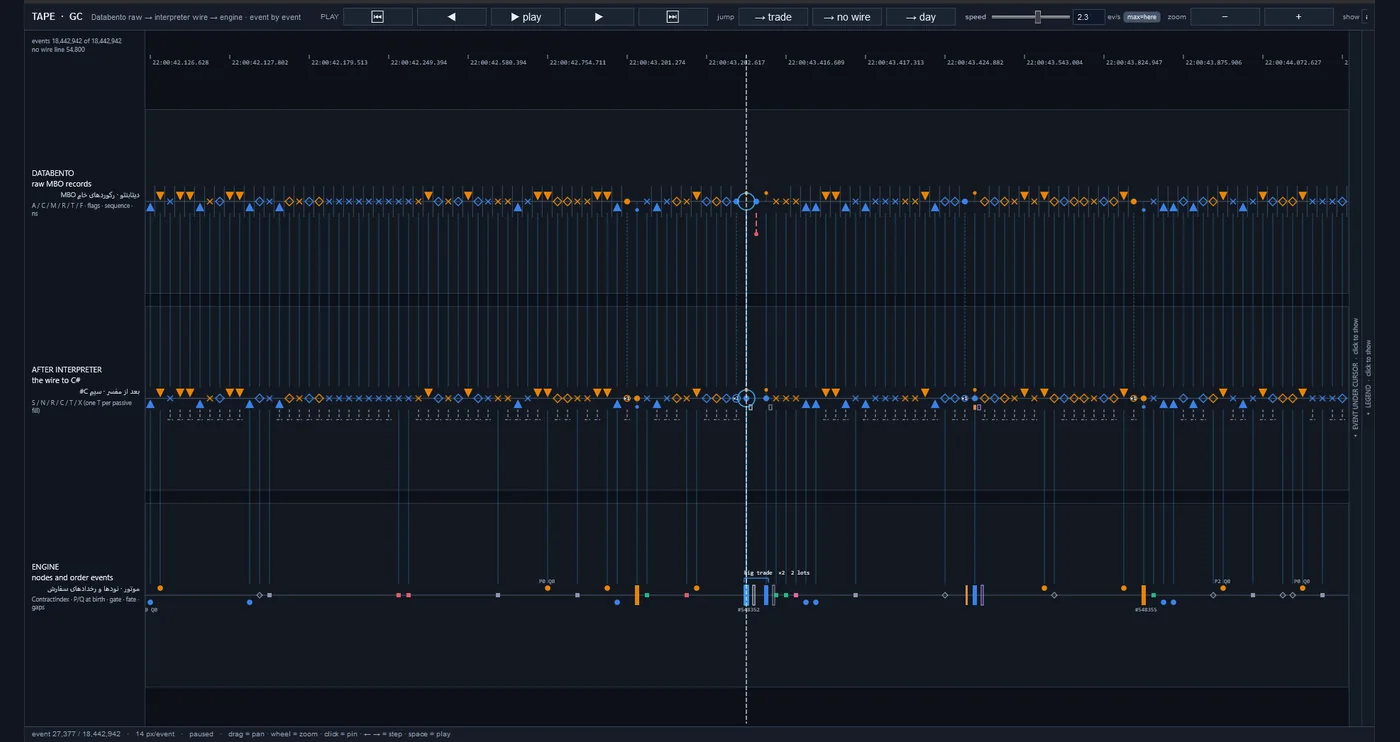
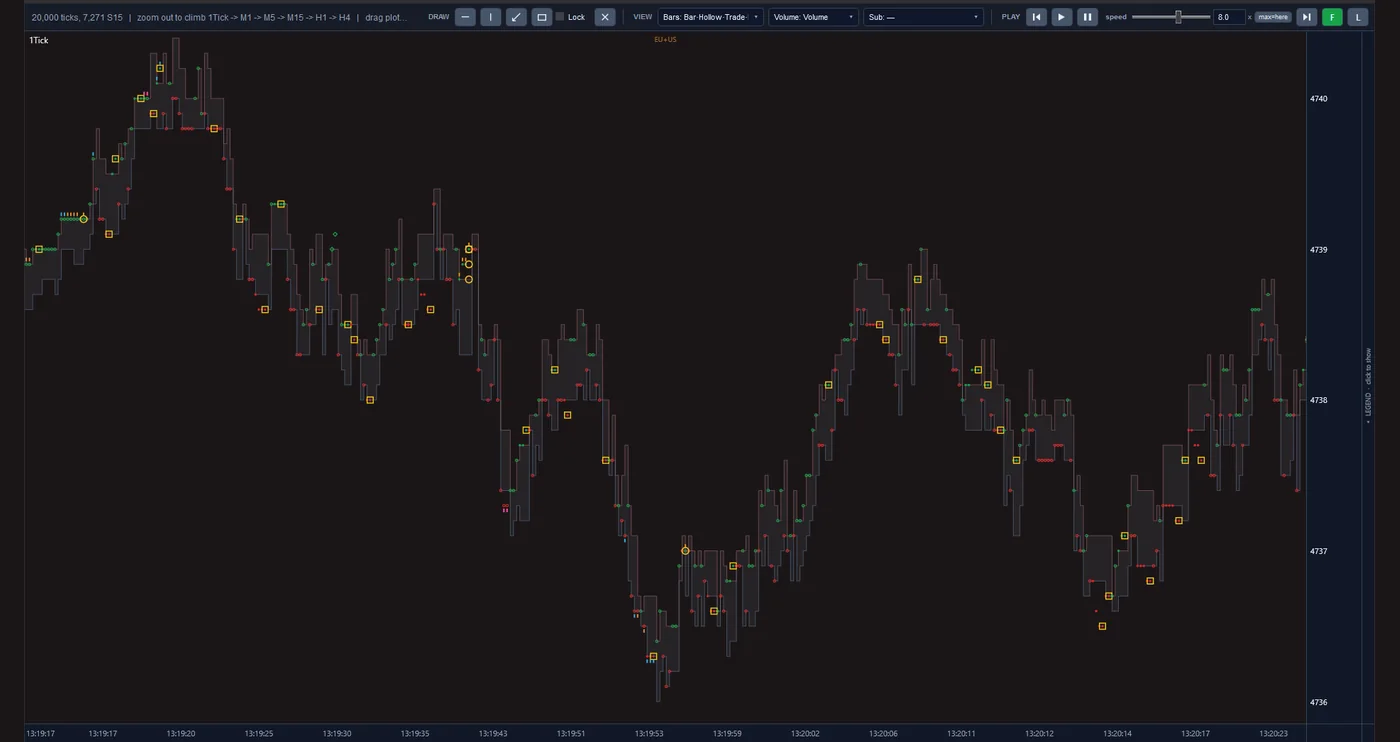
Das sind echte Bildschirmaufnahmen aus den Werkzeugen des Projekts, keine Mock-ups. Jede Ansicht zeigt dieselben Marktdaten auf Order-Ebene aus einem anderen Blickwinkel. Klicken Sie auf das Bild, um es zu vergrößern.
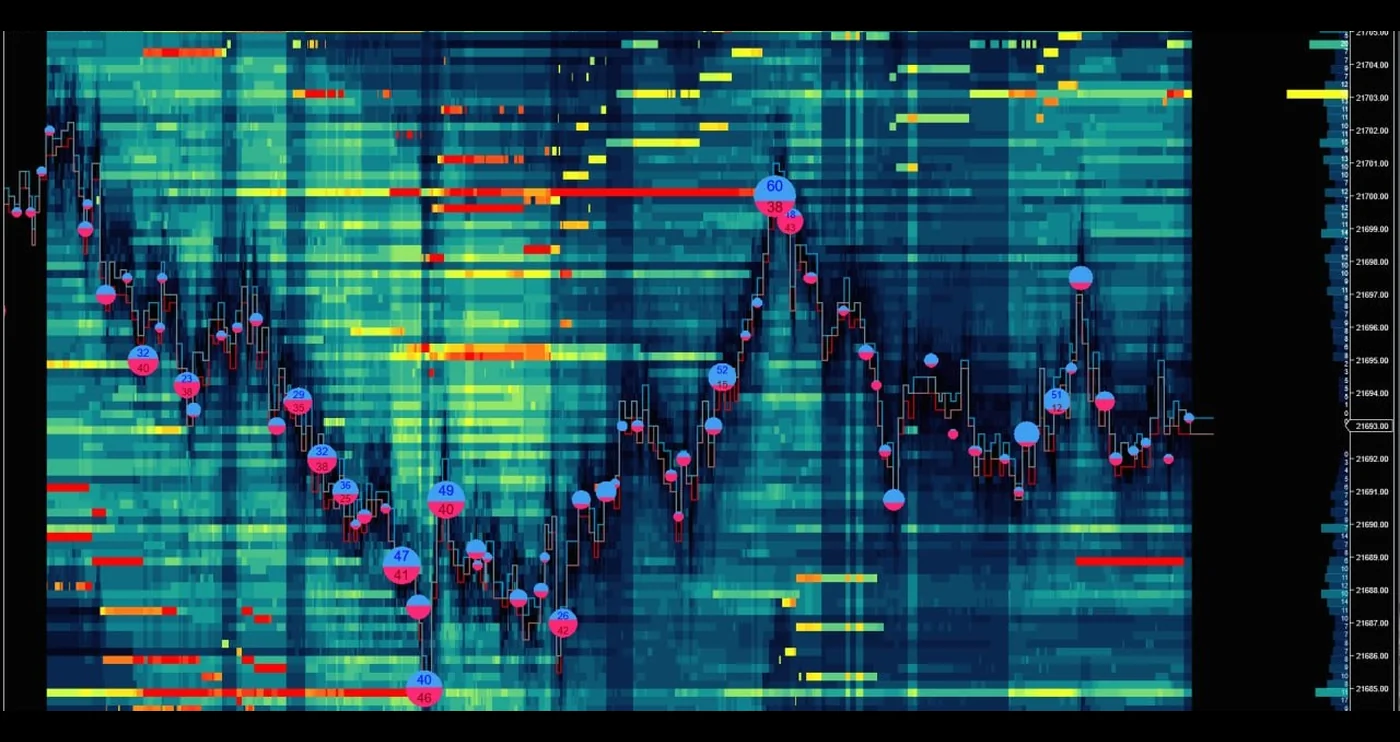
Das Volumen der bei jedem Preis und in jedem Moment wartenden Orders als Heatmap, darüber der Preisverlauf und Blasen, die die Trades markieren.
18.442.942 Ereignisse, einzeln durchlaufbar, in drei Bahnen: die rohen MBO-Datensätze, dieselben Datensätze nach dem Interpreter sowie die Knoten und Orderereignisse in der Engine.
Ein Ein-Tick-Preischart mit Ereignismarkern an jedem Tick. Beim Herauszoomen steigt die Ansicht von Ticks auf eine Minute und bis zu vier Stunden.
Ansatz
Der Algorithmus lernt aus Marktdaten und wird in einer Nachbildung desselben Marktes gemessen. Die Arbeit erfolgte in drei Stufen:
-
Von den Rohdaten zum vollständigen Bild des Marktes
Der Handelsbildschirm zeigt nur eine Zusammenfassung des Marktes. Wir verarbeiten jede Nachricht, die die Börse aufgezeichnet hat, und bilden die Liste der wartenden Orders für jeden Moment nach. Das Ergebnis ist ein Bild davon, wie viel Volumen bei jedem Preis wartet und in welcher Reihenfolge die Orders in der Warteschlange stehen.
-
Vom Bild des Marktes zum Algorithmus
Beim Deep Learning lernt der Computer Muster aus realen Beispielen, statt von Hand geschriebenen Regeln zu folgen. Auf diese Weise und gestützt auf statistische Analyse hat unser Algorithmus gelernt, in welchen Situationen der Trade eines Market Makers zu dessen Gunsten ausgeht und in welchen zu dessen Ungunsten. Sein Ergebnis sind drei Entscheidungen: wo eine Order zu platzieren ist, welcher Trade zu meiden ist und wann es gilt, zur Seite zu treten.
-
Vom Algorithmus zur getesteten Ausführung
Eine richtige Entscheidung muss sich im realen Markt auch ausführen lassen. In unserem Simulator erreichen die Orders des Algorithmus die Börse mit Verzögerung, warten in der Warteschlange, bis sie an der Reihe sind, und wirken auf den Markt, genau wie in der Realität. Der Maßstab ist das Netto-Finanzergebnis nach allen Kosten.
Was heraussticht
-
Wissen, das im System liegt, nicht in den Köpfen von Menschen.
Traditionelles Market Making stützt sich auf die Intuition versierter Trader, und dieses Wissen geht verloren, wenn sie gehen. Unser Algorithmus hat, was er weiß, aus den Marktdaten selbst gelernt. Dieses Wissen ist festgehalten, wiederholbar und lässt sich neu trainieren.
-
Auswahl, nicht ständige Präsenz im Markt.
Wir haben beidseitiges Quotieren ohne Auswahl zu realen Kosten gemessen, und es verlor Geld, denn ein Market Maker, der nicht auswählt, handelt meist dann, wenn der Preis kurz davor ist, sich gegen ihn zu bewegen. Genau dort liegt der Wert des Algorithmus: zu erkennen, welchen Trade man will und von welchem man Abstand nimmt.
-
Ein Ergebnis, das auch in der Ausführung Bestand hat.
Viele Strategien sind auf dem Papier profitabel und in der Praxis nicht, weil ihr Test annimmt, dass eine Order sofort zum angezeigten Preis ausgeführt wird. In unserem Simulator nimmt eine Order denselben Weg wie im realen Markt, und die Korrektheit der Simulation wurde gegen eine unabhängige Nachbildung aus den Rohdaten der Börse geprüft.
-
Eine echte Erkenntnis vom Zufall unterscheiden.
Lernmodelle können die Vergangenheit auswendig lernen, ohne etwas über die Zukunft gelernt zu haben. Um das zu vermeiden, wird der Algorithmus stets auf Zeiträumen gemessen, die er im Training nicht gesehen hat, turbulente eingeschlossen. Jede Erkenntnis wird außerdem neben Daten gestellt, denen gezielt jedes aussagekräftige Muster entzogen wurde, und wenn sie sich auch dort zeigt, wird sie verworfen.
-
Den Infrastrukturbedarf kennen, bevor man dafür bezahlt.
In diesem Feld entscheiden die Geschwindigkeit, mit der eine Order die Börse erreicht, und die Gebühr je Trade über die Grenze zwischen Gewinn und Verlust, und jedes von beiden zu verbessern ist teuer. Wir testen den Algorithmus über eine Bandbreite dieser Bedingungen zugleich. So ist vor jeder finanziellen Verpflichtung klar, unter welchen Bedingungen das Vorhaben gerechtfertigt ist.
-
Standardisierte, lesbare Berichte.
Das Ergebnis jedes Tests wird auf einer Seite dargestellt, mit den branchenüblichen Kennzahlen und Bezeichnungen, in fünf Sprachen. Ein Investor oder sein Berater kann das Ergebnis unabhängig von uns lesen und bewerten.
Der weitere Weg
-
Erledigt
Die Dateninfrastruktur, die Marktnachbildung, der Market-Making-Algorithmus, der Ausführungssimulator und das Berichtssystem sind gebaut.
-
Aktuell
Heute messen wir den Algorithmus in einem mehrjährigen Test, unter verschiedenen Geschwindigkeits- und Gebührenbedingungen und auf mehr als einem Markt.
-
Als Nächstes
Danach folgen die Anbindung an Live-Daten, die Bereitstellung in Börsennähe und eine Probephase mit begrenztem Kapital.
-
Letzter Schritt
Der letzte Schritt ist Market Making mit echtem Kapital, als automatisierter Desk.
Technologie
Die Lernmodelle werden in Python gebaut und auf einem Grafikprozessor trainiert. Die Engine der Marktnachbildung und der Ausführungssimulator sind in C# geschrieben, der Rohdaten-Reader in Rust. Eine Änderung wird erst angenommen, nachdem sie mit der vorherigen Version verglichen wurde und die automatisierten Tests bestanden hat.